RabbitMQ та Kafka: історична еволюція та архітектурний вибір
Анотація
У сучасній інженерії розподілених систем класичне протиставлення Apache Kafka та RabbitMQ давно втратило практичну актуальність: зрілі корпоративні архітектури використовують обидві платформи у взаємодоповняльному симбіозі. Проте для усвідомленого проєктування інфраструктури критично важливо розуміти не просто абстрактні відмінності систем, а фундаментальні причини, чому кожна з них спроєктована саме так на рівні фізики накопичувачів, мережевих протоколів та математичних обмежень розподіленого консенсусу.
У статті здійснено ретроспективний аналіз двадцятирічної еволюції систем обміну повідомленнями – від зародження відкритого стандарту AMQP (2003) та кризи черг при масштабуванні LinkedIn (2010) до конвергенції рішень у 2020–2026 роках (поява RabbitMQ Streams та перехід Kafka на протокол KRaft). Дослідження спирається на метрики індустрії, формальні теореми розподілених обчислень та емпіричні виміри лабораторії Nokia Bell Labs. На завершення розглянуто щоденні виробничі виклики експлуатації обох систем та представлено архітектурну специфікацію їхнього спільного використання.
Вступ
Розвиток програмної інженерії за останні два десятиліття супроводжувався тектонічним зсувом від монолітних застосунків, де компоненти викликали один одного прямо в оперативній пам’яті через виклики функцій, до розподілених сервісних мереж. Початкові спроби будувати мікросервісні архітектури виключно на базі синхронної взаємодії за протоколами RPC або HTTP REST швидко зіткнулися з каскадними збоями: якщо один сервіс у ланцюжку починає деградувати або зазнає мережевого таймауту, затримки лавиноподібно накопичуються, вичерпуючи пули потоків клієнтських систем і спричиняючи повну недоступність платформи.
Асинхронний обмін повідомленнями перетворився на фундаментальну основу стійкості розподіленого середовища. Проміжне програмне забезпечення (Message-Oriented Middleware) виступає своєрідною нервовою системою сучасного бекенду: воно бере на себе функції буферизації сплесків вхідного навантаження, просторової та часової ізоляції сервісів і гарантованої доставки інформації.
Сьогодні в індустрії домінують дві визнані платформи з відкритим кодом – RabbitMQ та Apache Kafka. Навколо їхнього зіставлення існує велика кількість спрощених оглядів, які намагаються визначити «переможця» за суб’єктивними критеріями. Проте будь-яка інженерна система є оптимізацією під чітко окреслений набір фізичних та апаратних обмежень свого часу. Щоб сформувати розуміння, необхідно піднятися над рівнем окремих бібліотечних API й дослідити генезис обох технологій від першопринципів (First Principles).
Метрики ринку
Позиція Apache Kafka та RabbitMQ як двох ключових індустріальних стандартів підтверджується незалежними дослідженнями глобального ринку комерційної інфраструктури.
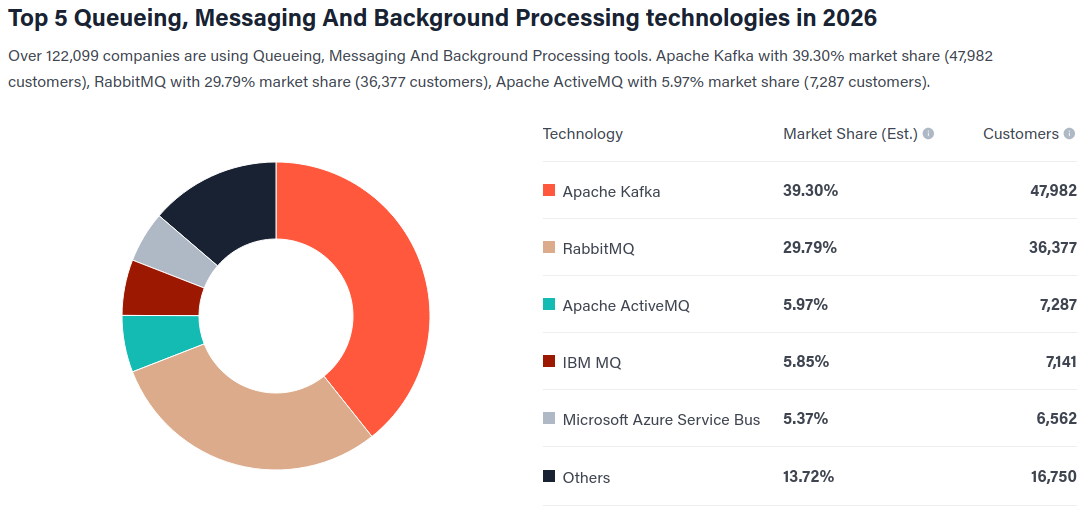 Рис. 1. Розподіл часток ринку технологій черг та обміну повідомленнями серед 122 099 компаній за даними 6sense Market Share Report 2026: домінування Apache Kafka (39.30%) та RabbitMQ (29.79%).
Згідно з аналітичними даними платформи B2B-аналітики 6sense (2026), на вибірці з понад 122 000 компаній у категорії Queueing, Messaging And Background Processing лідерство впевнено утримує Apache Kafka з часткою 39.30% (47 982 клієнти). RabbitMQ посідає другу сходинку з 29.79% (36 377 клієнтів).
Разом обидві платформи утворюють стійку індустріальну дуополію, охоплюючи майже 70% світового ринку. Усі альтернативні системи суттєво відстають за масштабом інсталяційної бази: найближчі конкуренти – Apache ActiveMQ (5.97%), IBM MQ (5.85%) та хмарний Microsoft Azure Service Bus (5.37%) – займають сумарно менше 18% ринку.
Теоретичний фундамент Pub/Sub
Перш ніж переходити до архітектурних деталей конкретних реалізацій, необхідно формалізувати теоретичні принципи систем публікації/підписки (Pub/Sub), спираючись на фундамент комп’ютерних наук (Computer Science).
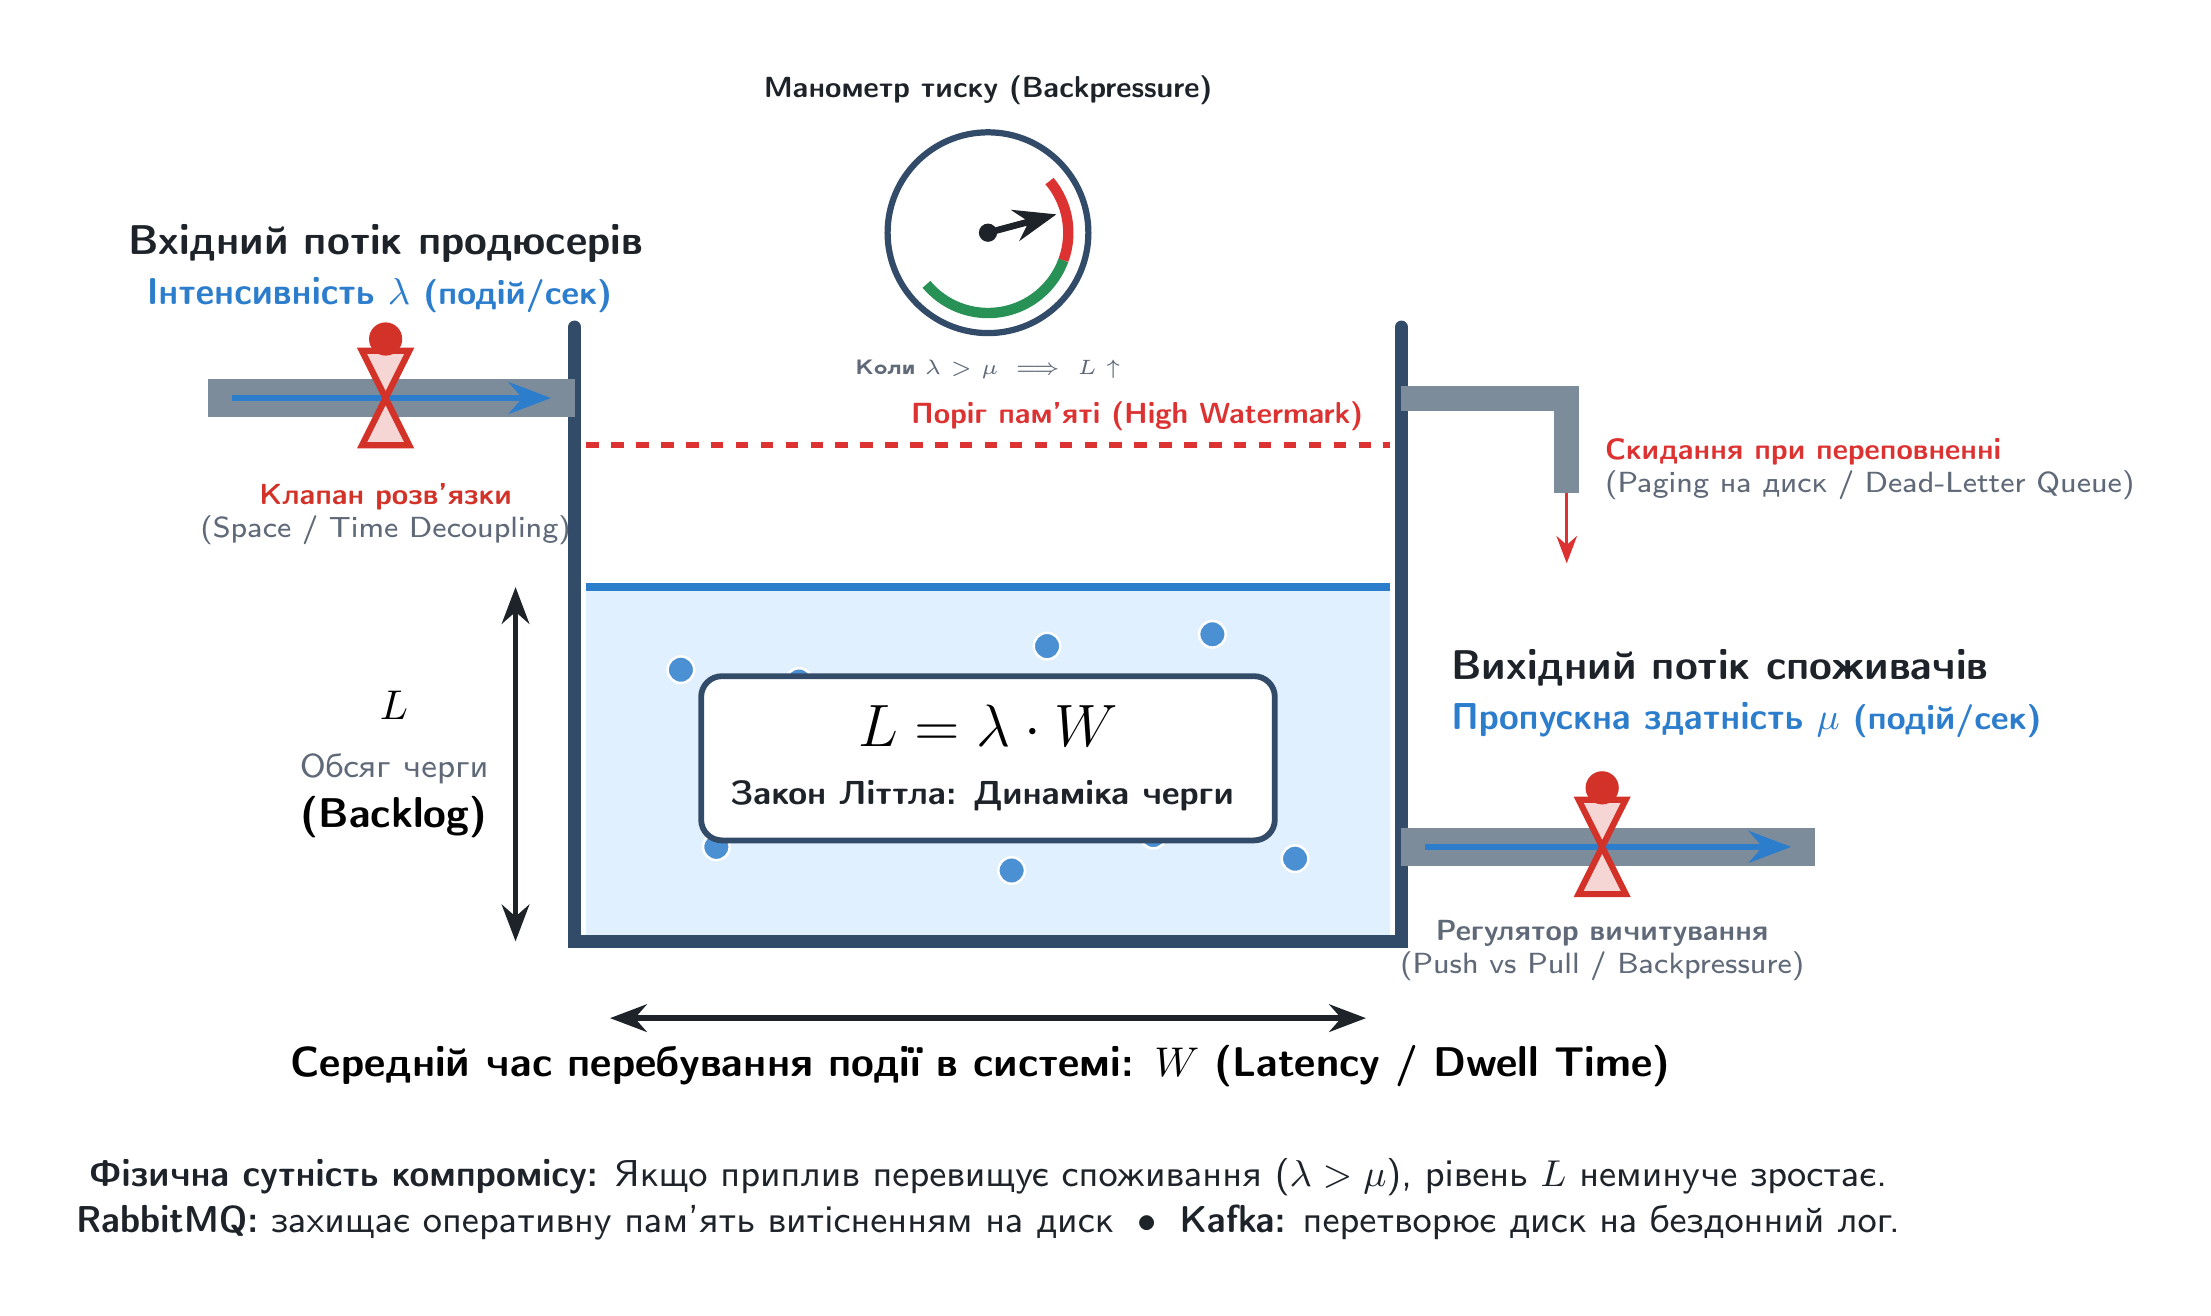 Рис. 2. Гідравлічна модель динаміки потоку та закону Літтла в системах Pub/Sub: взаємодія вхідної інтенсивності $\lambda$, розміру буфера $L$, часу затримки $W$ та виникнення тиску Backpressure.
1. Типи розв’язки (Decoupling) та принцип кінцевих точок
Згідно з фундаментальною класифікацією Ойгстера (Eugster et al., 2003, «The Many Faces of Publish/Subscribe»), ключова цінність моделі Pub/Sub полягає у забезпеченні слабкої зв’язності (loose coupling) за трьома вимірами:
- Просторова розв’язка (Space/Entity Decoupling): Відправники та одержувачі не володіють знаннями про топологічне розташування, мережеві IP-адреси чи внутрішню структуру один одного; уся взаємодія абстрагована брокером.
- Часова розв’язка (Time Decoupling): Взаємодіючі сторони не зобов’язані перебувати в активному стані одночасно. Продюсер публікує повідомлення, коли споживач може бути тимчасово офлайн, і навпаки.
- Синхронізаційна розв’язка (Synchronization Decoupling): Операції надсилання та отримання повідомлень виконуються асинхронно і не блокують потоки виконання бізнес-додатків.
Водночас за часову та просторову розв’язку доводиться розплачуватися втратою глобального узгодженого стану системи. Тут набуває чинності класичний End-to-End Principle (Салтцер, Рід та Кларк, 1984): надійність комунікації неможливо повністю перекласти на проміжне мережеве середовище. Навіть найнадійніший брокер не звільняє кінцеві додатки від необхідності самостійно перевіряти статус виконання операцій та контролювати цілісність даних.
2. Моделі підписки та складність маршрутизації
Маршрутизація повідомлень брокером визначає його обчислювальну ефективність:
- Topic-based маршрутизація: Повідомлення маркуються чіткими текстовими темами (можлива ієрархія та маски на кшталт
geo.alerts.kyiv). Рішення про маршрутизацію ухвалюється через швидкі хеш-таблиці або префіксні дерева (Trie) зі складністю $O(1)$ або $O(K)$, де $K$ – довжина ключа. - Content-based маршрутизація: Маршрутизація спирається на розбір значень усередині тіла повідомлення (наприклад, перевірка предикатів
severity > 3 AND region == 'Kyiv').
З погляду обчислювальної геометрії та теорії складності, задача зіставлення довільних складених предикатів на тілі пакета еквівалентна задачі локалізації точки в багатовимірному просторі (Point Location in Arrangements). Загальна складність такого парсингу може досягати $O(N)$ від кількості правил або бути NP-повною для довільних диз’юнкцій. Саме тому як RabbitMQ, так і Kafka відкинули ідею глибокого парсингу тіла повідомлень на рівні брокера, зберігши швидкодію центральних вузлів за рахунок простих ключів маршрутизації та топіків.
3. Гарантії доставки та неможливість детермінованого консенсусу
Розподілені брокери пропонують три базові моделі доставки:
- At-most-once («щонайбільше один раз»): Повідомлення відправляється без підтвердження або повторних спроб. Втрата пакета можлива при будь-якому мережевому збої. Модель забезпечує мінімальні затримки та нульові накладні витрати на збереження стану.
- At-least-once («щонайменше один раз»): Гарантується, що повідомлення буде успішно отримане, проте через таймаути мережі та повторні відправки виникають дублікати.
- Exactly-once («суворо один раз»): Стан, коли кожна подія обробляється кінцевою системою рівно один раз без втрат і дублювання.
Фундаментальна комп’ютерна наука стверджує: суто на транспортному рівні розподіленої мережі гарантія Exactly-Once неможлива. Це випливає з Задачі двох генералів (Two Generals’ Problem, Akkoyunlu et al., 1975; популяризовано Jim Gray, 1978) та Теореми неможливості FLP (Fischer, Lynch, Paterson, 1985): в асинхронній мережі неможливо досягти абсолютно надійного консенсусу між вузлами за наявності ненадійного каналу зв’язку за фіксовану скінченну кількість повідомлень.
Маркетинговий термін «Exactly-Once Semantics» (EOS) у сучасних системах – це комбінація At-Least-Once доставки на рівні транспорту та дедуплікації або ідемпотентної обробки на стороні сховища чи кінцевого споживача.
4. Гарантії порядку та релятивізм часу в розподіленій мережі
- Глобальний порядок (Total Order): Усі повідомлення у всій системі впорядковані в єдину хронологічну послідовність.
- Партиційований порядок (Partitioned / Partial Order): Порядок суворо зберігається лише в межах одного логічного каналу або партиції.
У 1978 році Леслі Лампорт опублікував фундаментальну працю «Time, Clocks, and the Ordering of Events in a Distributed System», де довів: у розподіленій системі фізичний час є відносним через дрейф апаратних годинників та недетерміновані мережеві затримки. Єдиним математично строгим способом впорядкування подій є відношення логічного слідування («happened-before», $\rightarrow$).
Для забезпечення глобального абсолютного порядку потрібен єдиний централізований координатор або важкі протоколи розподіленого консенсусу, що робить пропускну здатність системи обернено пропорційною мережевому діалогу між вузлами. Apache Kafka геніально застосувала висновок Лампорта: замість нездійсненного глобального порядку вона запровадила суворий частковий порядок всередині партиції. Події одного бізнес-об’єкта завжди потрапляють в одну партицію за спільним ключем і обробляються строго послідовно, дозволяючи решті системи масштабуватися лінійно.
5. Надійність, доступність та ціна реплікації
Будь-яка система розподіленого обміну повідомленнями підпорядковується CAP-теоремі Еріка Брюера (доведеній Гілбертом та Лінч у 2002 році) та її розширенню – PACELC-теоремі Деніела Абаді (2012).
PACELC стверджує: якщо в системі виникає мережеве розділення ($P$), архітектор обирає між доступністю ($A$) та узгодженістю ($C$). Але навіть якщо система працює в штатному режимі без розділень ($E$ – else), вона змушена постійно балансувати між затримкою ($L$ – Latency) та узгодженістю ($C$ – Consistency).
Синхронна реплікація на кворум вузлів (параметр acks=all у Kafka або Quorum Queues на базі Raft у RabbitMQ) сплачує прямий штраф часом: продюсер змушений очікувати підтвердження від віддалених вузлів через мережевий сокет і скидання даних на диск, що безпосередньо обмежує пікову продуктивність брокера.
6. Закони пропускної здатності та накопичення черг
Динаміка поведінки брокерів під навантаженням описується Законом Літтла (Little’s Law) з теорії масового обслуговування: \(L = \lambda W\) де $L$ – середня кількість повідомлень, що перебувають у черзі брокера; $\lambda$ – інтенсивність надходження повідомлень від продюсерів; $W$ – середній час перебування повідомлення в системі (від публікації до підтвердження консьюмером).
Якщо споживачі починають відставати від інтенсивності продюсерів хоча б на 5%, $L$ починає лінійно зростати. У цей момент проявляються внутрішні архітектурні механізми кожної системи: RabbitMQ змушений витрачати пам’ять на структури черг та скидати їх на диск, а Kafka продовжує послідовно записувати байти у фіксовані файли сегментів.
Дві парадигми втілення Pub/Sub
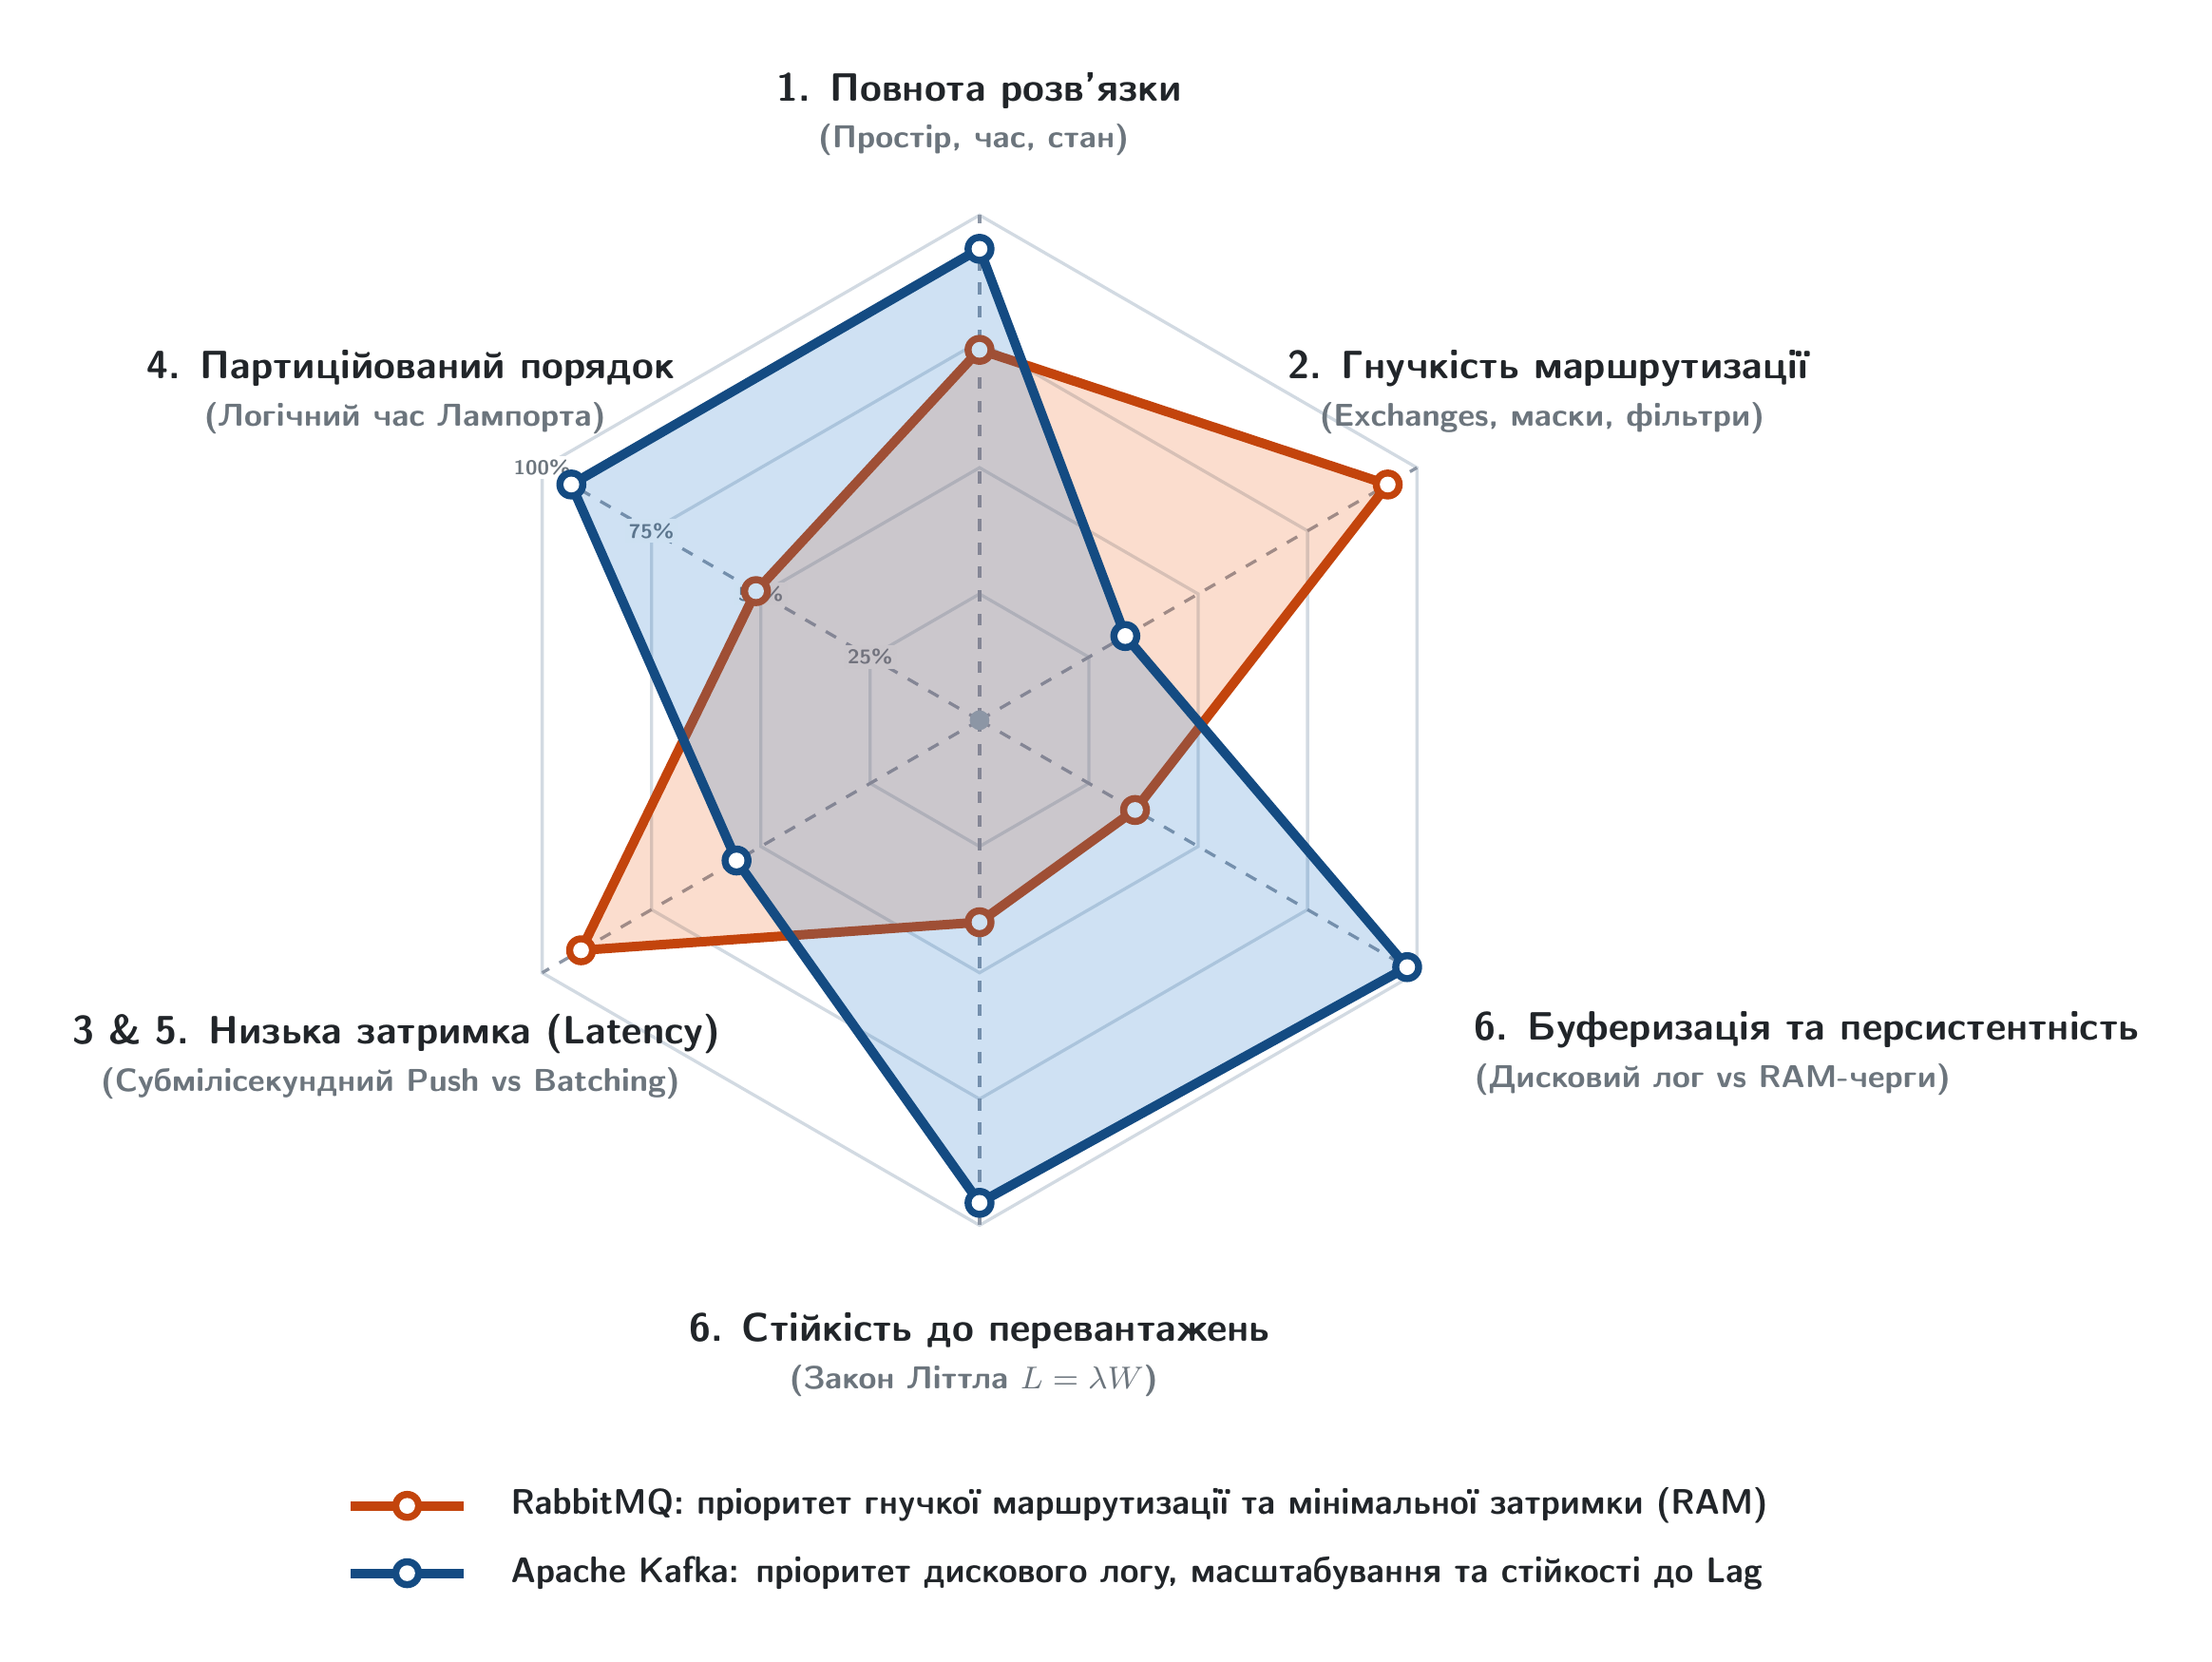 Рис. 3. Модель фундаментальних компромісів: зіставлення профілів RabbitMQ та Apache Kafka за шістьма вимірами розподілених систем.
Описаний теоретичний фундамент доводить, що універсальної системи обміну повідомленнями «для всього» не існує: компроміси теорем FLP, PACELC та фізика дискового вводу/виводу неминуче змушують обирати пріоритети (Рис. 3). Інженерна індустрія відповіла на ці обмеження появою двох кардинально відмінних архітектурних парадигм:
- Парадигма черг та обмінників (RabbitMQ / AMQP): концепція «Розумного брокера» (Smart Broker / Simple Consumer). Продюсер маркує повідомлення ключем маршрутизації, а брокер в оперативній пам’яті комутує його через обмінники (Exchanges) у відповідні буферизовані черги (Queues), звідки дані проштовхуються (Push) споживачам і деструктивно видаляються після підтвердження (ACK).
- Парадигма розподіленого логу (Apache Kafka): концепція «Мінімалістичного брокера» (Simple Broker / Smart Consumer). Брокер усунуто від бізнес-маршрутизації та відстеження стану клієнтів. Повідомлення послідовно записуються у незмінний дисковий лог (Append-Only Log), а незалежні консьюмери самі контролюють темп споживання, вичитуючи пакети (Pull) за числовим індексом зміщення (Offset).
Витоки RabbitMQ (2006–2007)
Контекст індустрії
На початку 2000-х років корпоративний сектор перебував у заручниках важких комерційних систем обміну повідомленнями. Фінансові інституції та банки користувалися рішеннями на кшталт IBM WebSphere MQ або TIBCO Rendezvous. Ці продукти коштували сотні тисяч доларів ліцензійних відрахувань, вимагали спеціалізованого апаратного забезпечення і жорстко прив’язували клієнтів до закритого вендорського стеку (Vendor Lock-in).
Спроба стандартизувати цей рівень за допомогою специфікації JMS (Java Message Service) зазнала лише часткового успіху: JMS стандартизував виключно Java API, але залишив невизначеним сам мережевий бінарний протокол. Сервіс на C++ або .NET не міг без важких проміжних шлюзів спілкуватися з чергою Java.
Хто і навіщо створював
У 2003 році Джон О’Хара (John O’Hara) в інвестиційному банку JPMorgan Chase ініціював розробку універсального, відкритого wire-level протоколу обміну повідомленнями – AMQP (Advanced Message Queuing Protocol). До 2006 року навколо ініціативи сформувався консорціум за участю Cisco, Red Hat та iMatix, і була опублікована перша відкрита специфікація (AMQP 0-8).
Фінансовий сектор висував жорсткі вимоги: торгові дески, бекенди розрахунків та системи управління ризиками писалися на різних технологіях (C++, Java, C#, Python) і не мали змоги безпосередньо взаємодіяти. Ліцензії комерційних брокерів коштували мільйони доларів за процесорне ядро, а будь-яка спроба вендорської модернізації загрожувала блокуванням бізнесу. Мета полягала у створенні відкритого протоколу рівня TCP для повідомлень, який дозволив би гетерогенним системам спілкуватися без проміжних адаптерів.
Для розробки еталонної реалізації відкритого стандарту в Лондоні об’єдналися дві компанії – LShift та CohesiveFT, заснувавши спільне підприємство Rabbit Technologies Ltd на чолі з Алексісом Річардсоном (Alexis Richardson) та Маттіасом Радестоком (Matthias Radestock). Продукт отримав назву RabbitMQ.
Архітектура та витоки набору рішень
Увесь комплекс архітектурних рішень RabbitMQ був строго продиктований бізнес-реаліями Волл-стріт та фінансового ринку середини 2000-х років:
- Вибір Erlang/OTP та модель акторів:
Банківська інфраструктура вимагала безперервної доступності рівня п’яти дев’яток (99.999%) і вище. Джо Армстронг у компанії Ericsson створив платформу Erlang/OTP для телекомунікаційних комутаторів (зокрема станцій AXD301), де збій телефонного з’єднання одного абонента в жодному разі не повинен призводити до аварії всієї підстанції. У телекомі AXD301 продемонстрував знамениті «дев’ять дев’яток» надійності (99.9999999%), що зробило Erlang привабливим і для фінансового сектору.- У RabbitMQ кожна черга – це окремий мікроскопічний процес-актор Erlang (розміром лише кілька кілобайт) із власною пам’яттю та власним збирачем сміття (GC).
- Принцип «Let it crash» та ієрархія супервізорів: Якщо обробка повідомлення або непередбачена помилка викликає аварійне завершення процесу черги, локальний супервізор Erlang миттєво перезапускає її ізольовано. Решта десятків тисяч черг продовжують працювати без найменшого впливу.
- Відсутність спільної блокованої пам’яті (shared-nothing state) усунула глобальні блокування (Deadlocks) та зупинки на збирання сміття (Stop-the-world pauses), які були головним лихом тодішніх систем на JVM.
- Розділення топології (Exchanges, Queues, Bindings):
Чому повідомлення не надсилається напряму в чергу? У біржовій торгівлі продюсер (наприклад, торговий термінал) лише декларує намір (order.equity.nyse). Він не повинен знати, скільки підсистем зацікавлені в цьому повідомленні – клірингова система, система комплаєнс-аудиту чи модуль ризик-аналізу.- Обмінник (Exchange) інкапсулює логіку маршрутизації (Direct, Fanout, Topic, Headers).
- Черги (Queues) виступають незалежними поштовими буферами завдань для конкретних споживачів.
- Зв’язування (Bindings) конфігуруються системними адміністраторами на льоту. Це дозволило додавати нові регуляторні сервіси чи аудит без зупинки системи і без внесення змін до коду продюсерів.
-
Ментальна модель «повідомлення як транзакційна команда» та деструктивне читання:
У 2006 році повідомлення сприймалося не як пасивна подія для аналітики, а як імперативна команда або транзакція («виконати платіж №142», «розрахувати ордер»). Щойно консьюмер успішно опрацював повідомлення і повернув підтвердження (basic.ack), брокер негайно знищував запис з оперативної пам’яті. Утримувати оброблені завдання в RAM не мало практичного сенсу: пам’ять у серверах середини 2000-х коштувала надзвичайно дорого, а брокер розглядався як високошвидкісний мережевий комутатор, а не база даних. - Push-модель доставки:
Для біржових котирувань та фінансових транзакцій навіть кілька мілісекунд затримки мали критичну ціну. Опитування черги консьюмерами (Polling) створювало б нераціональне навантаження на процесор і неприпустимий дрейф латентності. Push-модель забезпечувала миттєву передачу: щойно повідомлення потрапляло в чергу, Erlang спрямовував його безпосередньо у відкритий TCP-сокет підключеного споживача.
Q&A
- Чому RabbitMQ використовує Push за замовчуванням? Для фінансових транзакцій і біржових котирувань 2006 року затримка мала бути мінімальною. Постійне опитування (Polling) створювало б порожнє навантаження на процесор, тоді як Push забезпечував субмілісекундну реакцію на рівні оперативної пам’яті.
- Чому черги не призначені для зберігання великої історії? У класичній моделі кожна черга тримає метадані повідомлень у RAM. Якщо споживачі вимикаються і черга розростається до сотень тисяч записів, пам’ять вичерпується, змушуючи брокер екстрено скидати стан на диск через операції випадкового дискового вводу/виводу, що паралізує продуктивність.
- Як концепція «Let it crash» в Erlang захищає кластер RabbitMQ? Ізоляція черг як окремих процесів-акторів гарантує, що аварійне завершення процесу черги через некоректний стан чи виняток локалізується локальним супервізором і не призводить до каскадного падіння сусідніх черг брокера.
Виникнення Apache Kafka (2010–2011)
Контекст індустрії в LinkedIn
До 2010 року професійна соціальна мережа LinkedIn переживала вибухове зростання. Сотні мікросервісів обмінювалися даними за схемою «точка-точка». Постала потреба збирати два гігантські потоки даних:
- Потік дій користувачів (кліки, пошукові запити, перегляди сторінок).
- Операційна телеметрія сервісів (метрики продуктивності, журнали помилок).
Спроба агрегувати ці дані за допомогою популярного на той час брокера ActiveMQ (JMS) натрапила на фізичні обмеження архітектури:
- Щойно обсяг накопичених черг перевищував доступний обсяг виділеної оперативної пам’яті JVM, брокер переходив на випадковий дисковий ввід/вивід (Random Disk I/O). Швидкість обробки падала на порядки.
- Якщо одні й ті самі дані потрібні були аналітикам Hadoop, сервісу пошуку та системі виявлення шахрайства, брокер змушений був створювати окрему чергу для кожного підписника і тричі копіювати одні й ті самі повідомлення в пам’яті.
Хто розробляв
Інженери команди інфраструктури даних LinkedIn – Джей Крепс (Jay Kreps), Неха Нархеде (Neha Narkhede) та Джун Рао (Jun Rao) – вирішили відмовитися від класичної чергової концепції.
Систему назвали Apache Kafka на честь письменника Франца Кафки: за словами Крепса, оскільки система оптимізована для запису даних (writing), ім’я відомого письменника (writer) здалося доречним; до того ж він захоплювався творчістю Кафки ще з університету і вважав, що назва влучно звучить для open-source проєкту. У 2011 році проєкт відкрили в open-source під парасолькою Apache Software Foundation.
Зміна парадигми: незмінний Commit Log
Джей Крепс сформулював нову концепцію в маніфесті «The Log: What every software engineer should know about real-time data’s unifying abstraction»: брокер не повинен бути розумним диспетчером завдань. Він має бути простим, надшвидким розподіленим журналом фіксації (Distributed Append-Only Commit Log).
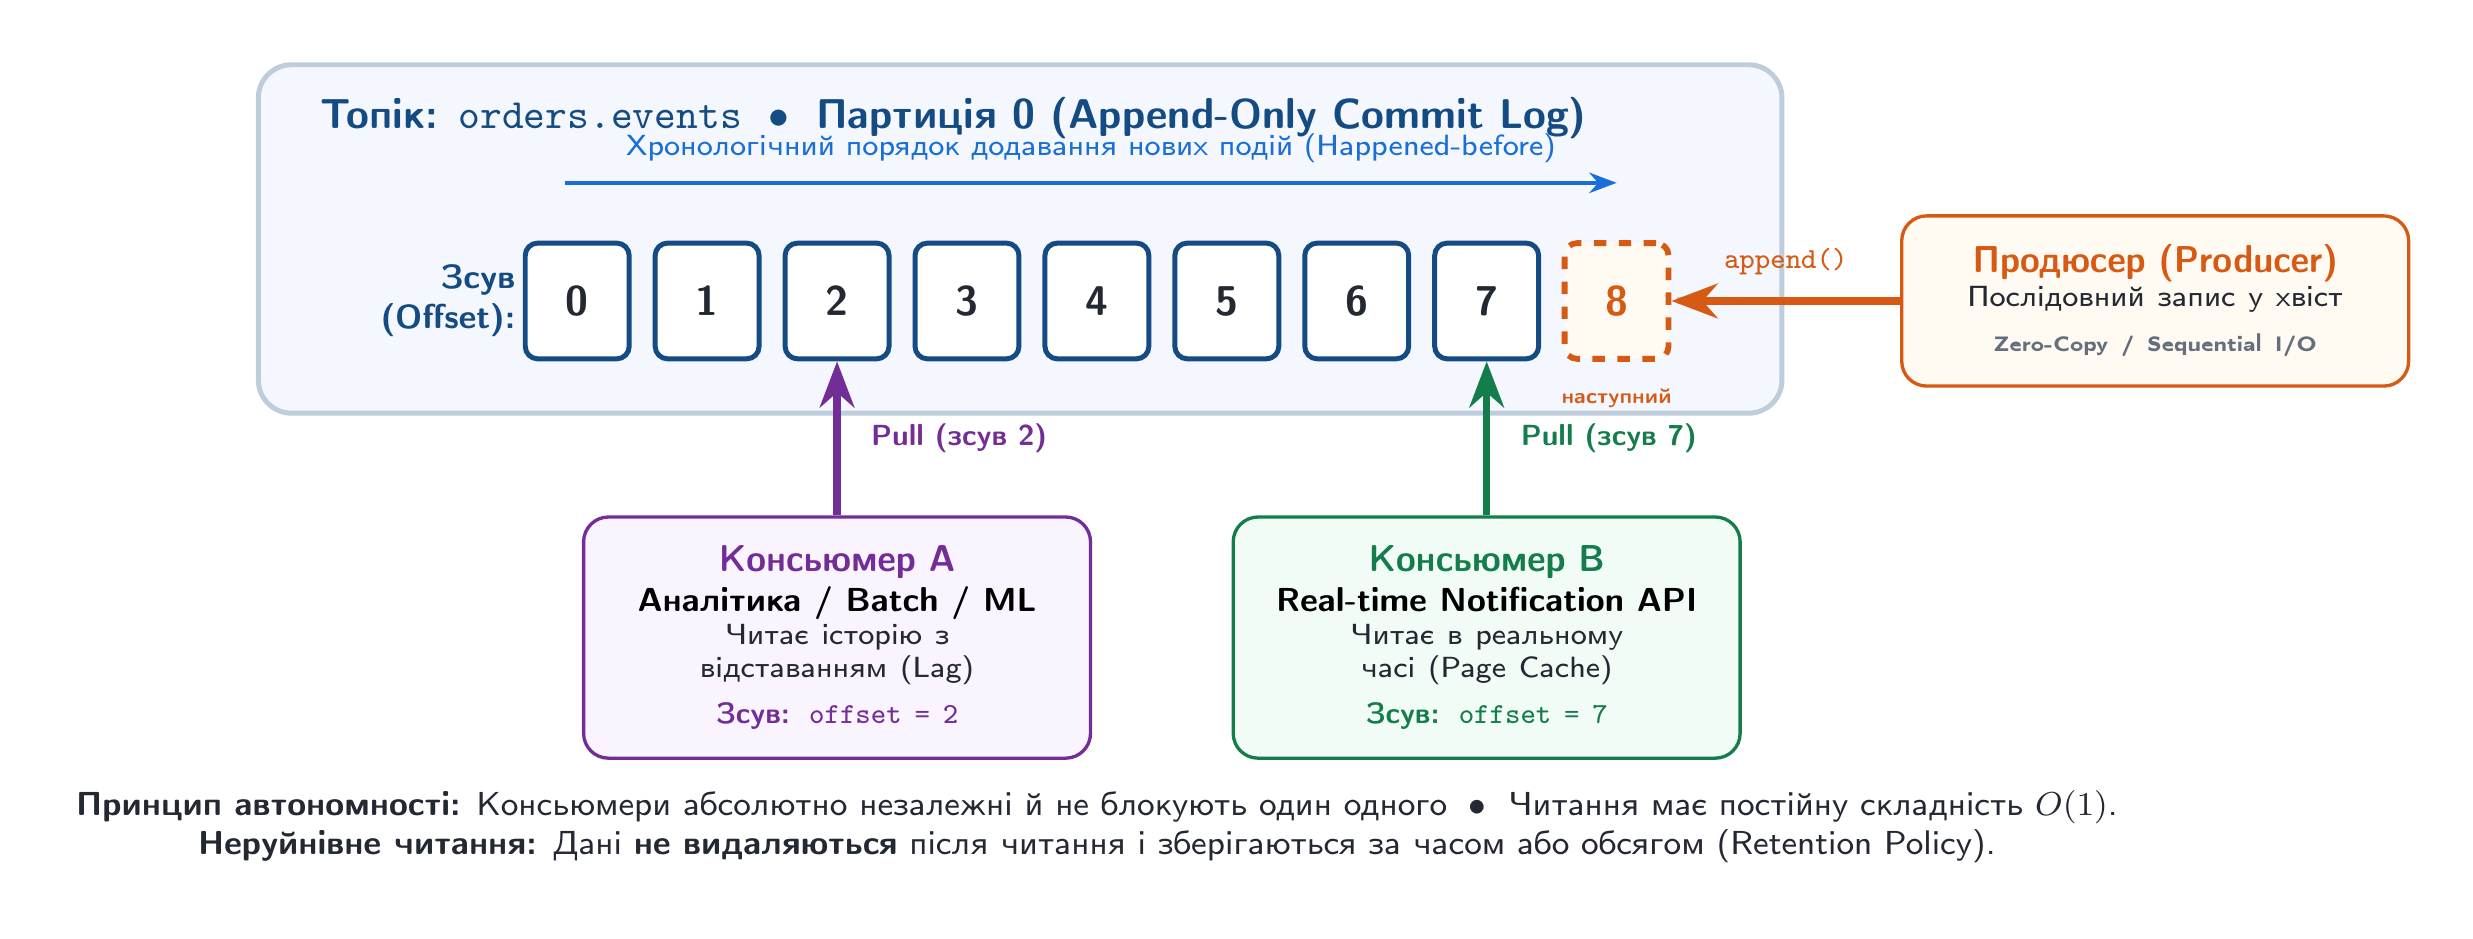 Рис. 4. Структура партиції Apache Kafka: послідовний append-only запис продюсером та незалежне неруйнівне читання автономними консьюмерами за числовим зсувом (Offset).
Архітектура Kafka спирається на ключові інженерні принципи розподілених систем:
- Послідовний доступ до диска (Sequential Disk I/O):
Випадковий доступ до блоків магнітного накопичувача чи SSD вимагає переміщення голівок або очищення сторінок пам’яті (затримки 5–10 мс). Послідовний запис блоків у кінець файлу (append-only) виконується за мікросекунди і за пропускною здатністю наближається до швидкості оперативної пам’яті (сотні мегабайт на секунду на звичайний HDD, гігабайти – на NVMe SSD). - Використання системного кешу ОС (Linux Page Cache):
Замість того, щоб кешувати об’єкти всередині простору користувача Java (JVM Heap) і створювати колосальний оверхед для збирача сміття (Garbage Collection pauses), Kafka довіряє кешування ядру операційної системи. Коли повідомлення надходить, воно записується в Page Cache ОС, і ядро саме скидає сторінки на диск фоновими потоками. - Нульове копіювання (Zero-Copy Data Transfer):
При читанні повідомлень споживачем брокер не затягує байти у простір пам’яті Java. За допомогою системного виклику ядра Linuxsendfile()байти пересилаються безпосередньо зі сторінкового кешу в мережевий сокетний буфер мережевої карти без участі процесора (Zero-Copy): \(\text{Page Cache} \xrightarrow{\text{Direct DMA Transfer}} \text{Network Interface Controller (NIC)}\) - Пасивний брокер та автономний клієнт (Smart Consumer):
Брокер не відстежує стан кожного консьюмера. Єдине, що фіксує система – це ціле число: зсув (Offset). Сам споживач пам’ятає, на якому зсуві він зупинився. Завдяки цьому додавання 10 нових споживачів до одного топіка створює нульовий додатковий оверхед на процесор брокера: читання з логу має складність $O(1)$. - Модель масштабування споживачів: партиції проти конкуруючих споживачів (Competing Consumers):
- У RabbitMQ діє патерн Competing Consumers: одну чергу можуть паралельно вичитувати хоч 50 воркерів. Брокер динамічно віддає чергове доступне повідомлення будь-якому вільному потоку. Масштабування консьюмерів є абсолютно еластичним, проте за це доводиться платити втратою суворого порядку обробки між конкурентними воркерами.
- У Kafka одиницею паралелізму є партиція: у межах однієї групи споживачів (
Consumer Group) діє жорстке правило «одна партиція – щонайбільше один активний консьюмер». Якщо топік налічує 8 партицій, підключення 10 подів у Kubernetes призведе до того, що 2 поди перебуватимуть у повному простої (idle). Збільшити паралелізм можна лише через адміністративне збільшення кількості партицій або ручне шардування пулу потоків усередині самого консьюмера.
Q&A
- Чому Kafka використовує Pull-модель? Споживачі мають різну обчислювальну потужність. За Push-моделі швидкий продюсер затопив би повільного консьюмера пакетами (Buffer Bloat). За Pull-моделі консьюмер самостійно контролює швидкість вичитки пачок (
batch.size) відповідно до своїх ресурсів. - Чому повідомлення не видаляються після читання? Потік подій є первинним джерелом правди (Event Sourcing). Дані зберігаються на основі політики часу або розміру (Retention Policy, наприклад, 7 днів або 1 ТБ). Один і той самий потік можуть паралельно та незалежно читати десятки систем у реальному часі чи ретроспективно.
- Чому ми не можемо просто підняти 100 консьюмерів для Kafka-топіка з 10 партиціями, і як цю проблему вирішує RabbitMQ? В одній Consumer Group кількість активних консьюмерів обмежена зверху числом партицій: брокер закріплює кожну партицію за конкретним клієнтом, аби гарантувати монопольний послідовний Offset без боротьби за блокування. Щоб паралелізувати 100 воркерів, у Kafka потрібно або розширити топік до 100 партицій, або вичитувати пачки консьюмером і диспетчеризувати їх у внутрішній пул потоків (ThreadPool). У RabbitMQ патерн Competing Consumers підтримується нативно з коробки: будь-яка кількість воркерів підключається до єдиної черги без попереднього планування чи переконфігурації топології.
Дослідження Nokia Bell Labs (2017)
У 2017 році дослідники Філіп Добеларе та Кюмарс Шейх Есмаїлі з дослідницького центру Nokia Bell Labs (Бельгія) опублікували фундаментальну працю на конференції ACM DEBS 2017 («Kafka versus RabbitMQ: A Comparative Study of Two Industry Reference Publish/Subscribe Implementations»).
Метою дослідження було усунення маркетингових маніпуляцій шляхом постановки суворого лабораторного експерименту з математичним моделюванням двох домінуючих архітектурних парадигм (Рис. 5).
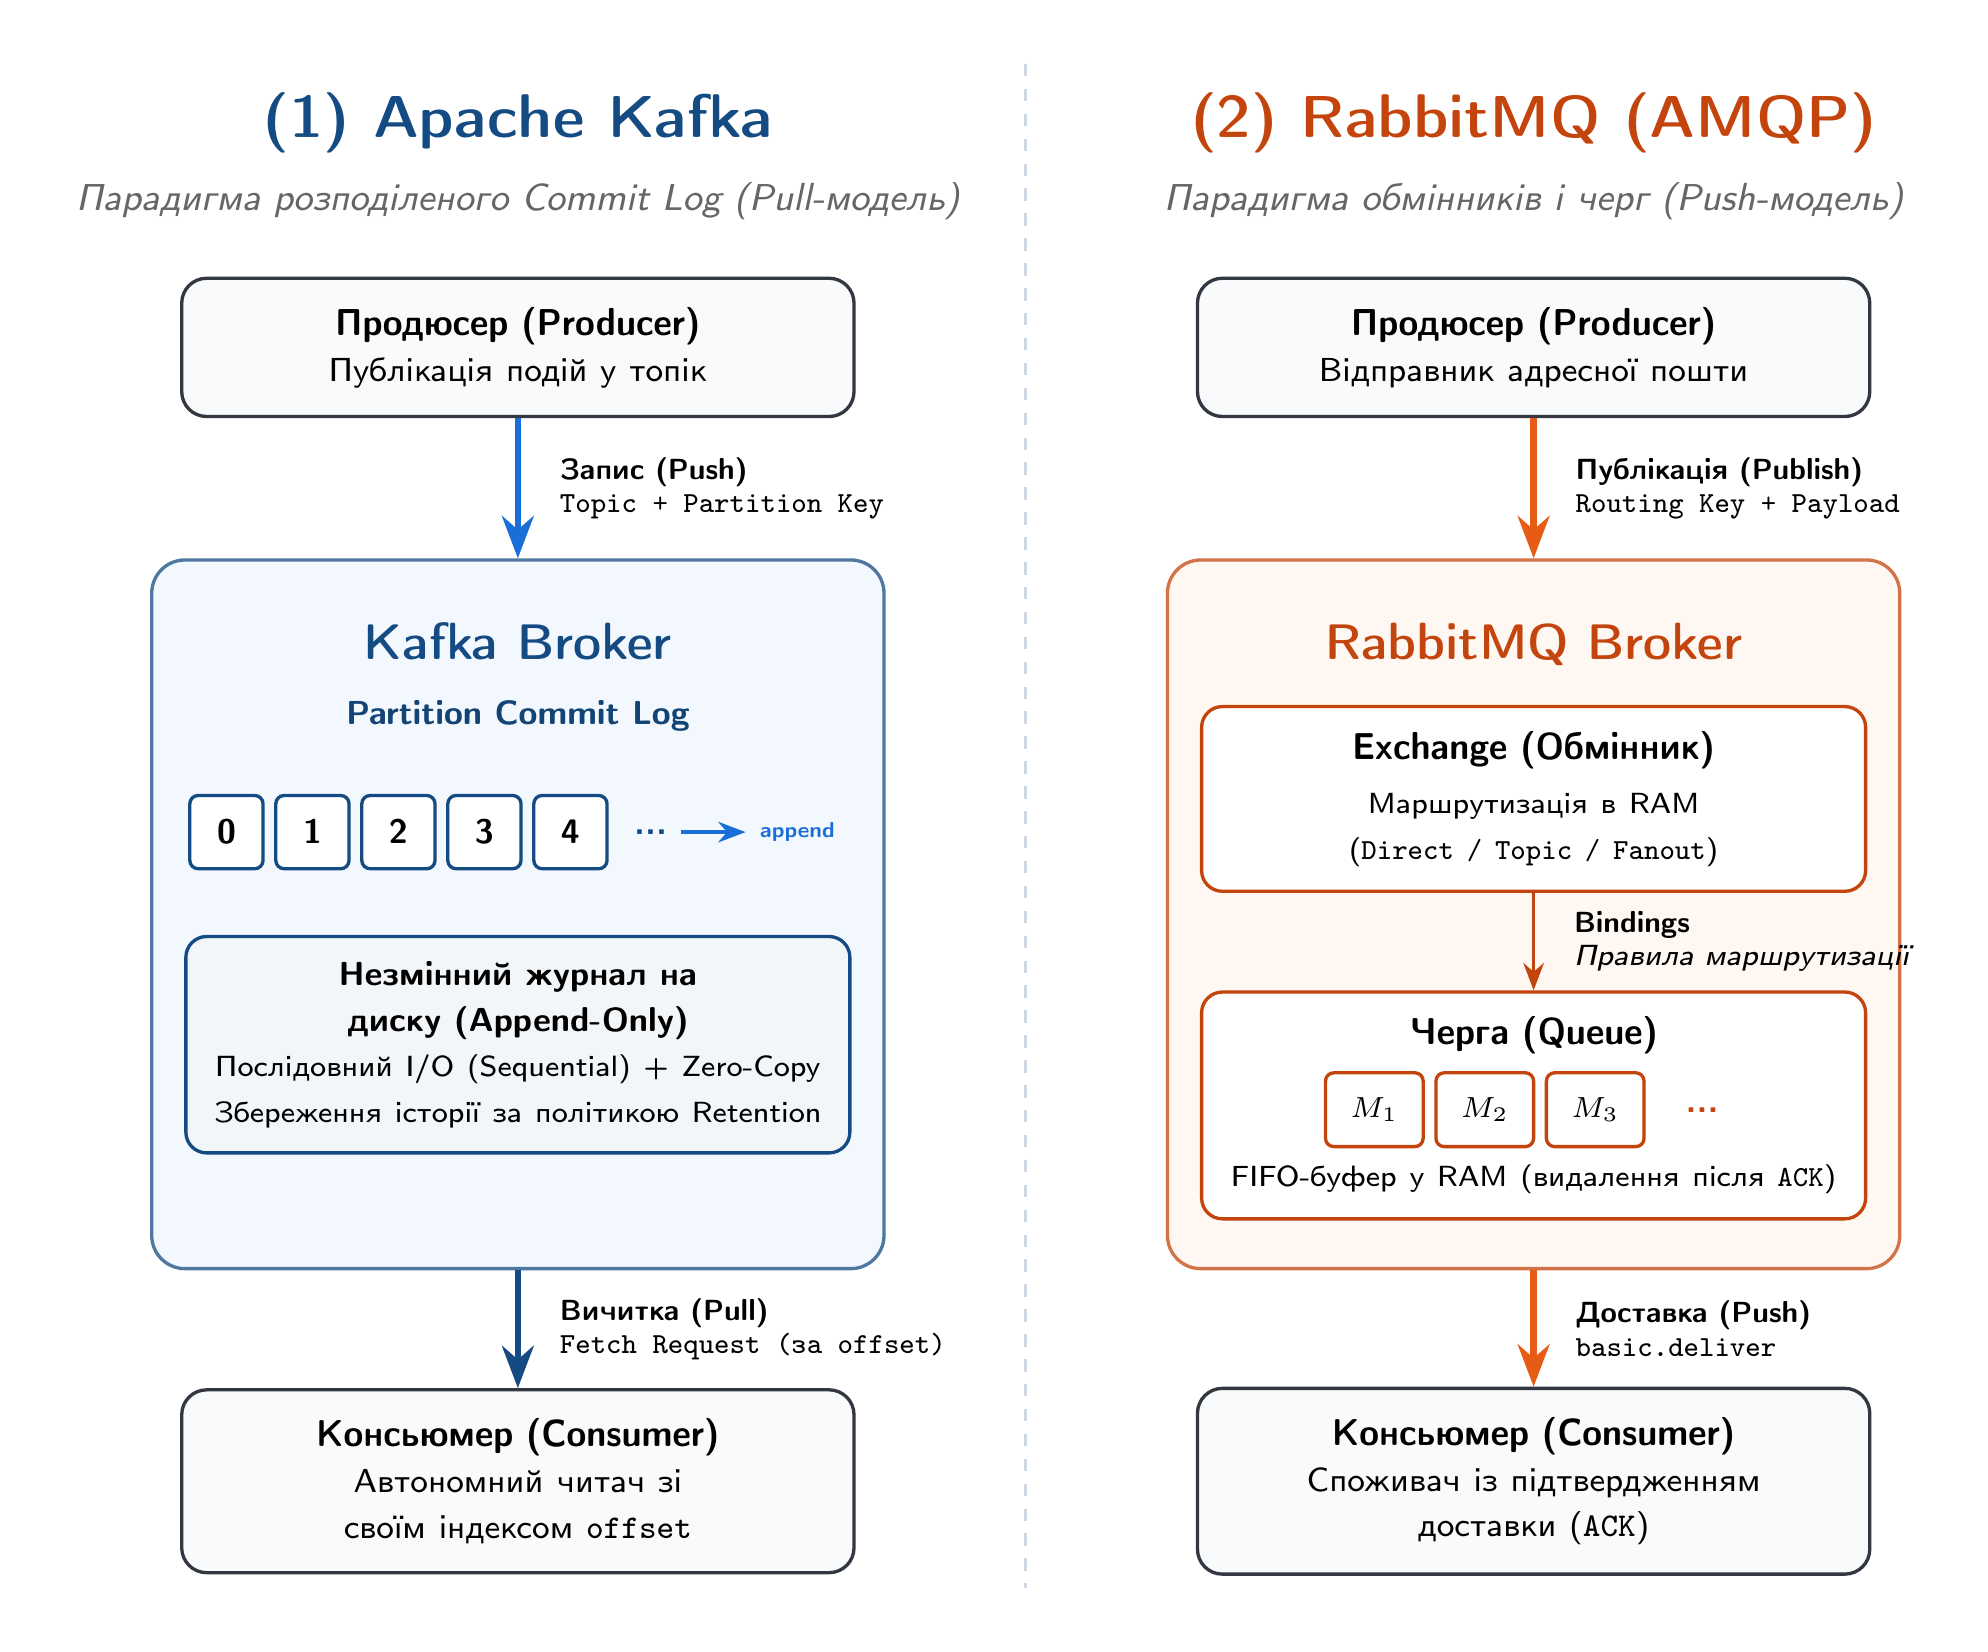 Рис. 5. Архітектурні моделі передачі повідомлень, досліджені Bell Labs: незмінний commit log Kafka (Pull-модель) проти обмінників і черг у пам’яті RabbitMQ (Push-модель).
1. Модель пропускної здатності
На основі емпіричних результатів дослідження Bell Labs, залежність пропускної здатності від розміру повідомлення можна формалізувати через вартість фіксованої комутації заголовків та обсягу корисного навантаження: \(T(S) \approx \frac{1}{U_{\text{routing}} + S \cdot U_{\text{byte}}}\) де:
- $S$ – розмір корисного навантаження (payload size, байт);
- $U_{\text{routing}}$ – процесорний час брокера, необхідний для комутації пакетів, парсингу заголовків і перевірки таблиць маршрутизації;
- $U_{\text{byte}}$ – час, необхідний для фізичного переміщення одного байта через шину пам’яті, шину вводу/виводу та мережевий адаптер.
Висновки формули:
- На малих повідомленнях (до 100–500 байт) домінує константа $U_{\text{routing}}$. Тут RabbitMQ демонструє блискучі результати завдяки швидкій комутації в оперативній пам’яті за допомогою легких процесів Erlang.
- На великих повідомленнях (від кількох кілобайт до мегабайта) вирішальним стає член $S \cdot U_{\text{byte}}$. Тут Apache Kafka повністю перемагає RabbitMQ завдяки Zero-Copy (
sendfile), пакетуванню (Batching) та відсутності копіювання байтів у просторі JVM.
2. Ціна надійності (Reliability Overhead)
Лабораторія Bell Labs кількісно виміряла деградацію пропускної здатності при переході від режиму «без збереження» (Transient / At-most-once) до режиму повної надійності з реплікацією (Persistent / Replicated / At-least-once):
- У RabbitMQ: увімкнення дискової персистентності та реплікації призвело до падіння пропускної здатності приблизно на 50%.
- У Kafka: увімкнення синхронної реплікації на кворум вузлів (
acks=all/ In-Sync Replicas) спричинило падіння Throughput приблизно на 75%.
Синхронна реплікація через мережу та збереження незмінного логу в Kafka накладають строгу ціну надійності: система платить пропускною здатністю за математичні гарантії неможливості втрати даних.
3. Моделювання затримки при відставанні консьюмера
На основі емпіричних спостережень Nokia Bell Labs щодо латентності при відставанні споживачів (Lagging Consumers), поведінку затримки можна формалізувати так: \(L_{\text{total}} = (1 - p_{\text{miss}}) \cdot L_{\text{RAM}} + p_{\text{miss}} \cdot L_{\text{Disk}}\)
- Поки споживач Kafka вичитує події безпосередньо за продюсером, ймовірність промаху повз кеш $p_{\text{miss}} \approx 0$. Затримка $L_{\text{RAM}}$ становить близько 1–3 мс.
- Якщо споживач зависає або відстає на кілька гігабайтів, дані витісняються зі сторінкового кешу Linux. Споживач змушений читати їх безпосередньо з дискового носія ($p_{\text{miss}} \to 1$). Затримка $L_{\text{Disk}}$ миттєво злітає до 50–100 мс.
Q&A
- Чому увімкнення синхронної реплікації обходиться дорожче для Kafka (-75% Throughput), ніж для RabbitMQ (-50%)? У RabbitMQ реплікація історично була реплікацією стану в пам’ять нод кластера. У Kafka модель надійності вимагає не просто відправки по мережі, а фіксації в незмінний журнал на диску кворуму In-Sync Replicas (ISR) з очікуванням підтверджень через мережеві сокети продюсера (
acks=all), що створює значно довший критичний шлях синхронізації. - Що відбувається з латентністю читання в Kafka, якщо консьюмер відстає (Consumer Lag)? Поки споживач читає свіжі дані, вони вичитуються безпосередньо з Linux Page Cache (латентність 1–3 мс). Щойно лаг перевищує обсяг кешу пам’яті, споживач потрапляє у стан Cache Miss і брокер змушений звертатися до фізичного диска, що спричиняє стрибок латентності в 10–50 разів (до 50–100 мс).
Еволюція бенчмарків та конвергенція систем (2020–2024)
У період з 2020 до 2024 року системи пройшли колосальний еволюційний шлях, запозичуючи сильні сторони одна одної.
1. Інженерні дискусії бенчмарків (2020)
У 2020 році компанія Confluent опублікувала порівняльне дослідження на базі стандартизованого тесту Linux Foundation OpenMessaging Benchmark, де декларувала значну перевагу Kafka над RabbitMQ за валовою пропускною здатністю та затримками під навантаженням.
Цей звіт викликав змістовну технічну відповідь з боку Джека Ванлайтлі (Jack Vanlightly, інженер VMware Tanzu, один із ключових дослідників розподілених черг). Ванлайтлі провів детальний аудит і розкрив фундаментальні архітектурні компроміси, приховані за «чистими» графіками:
- Агресивність пакетування (Batching): Kafka за замовчуванням агрегує повідомлення у пачки (
linger.ms,batch.size), демонструючи вражаючий Throughput ціною штучного очікування перших повідомлень у пачці на боці клієнта. RabbitMQ у тесті конфігурувався в режимі індивідуальної обробки кожного повідомлення (per-message delivery), що апріорі ставило його в нерівні умови за валовим тоннажем байтів. - Семантика скидання на диск (
fsync): Було продемонстровано, що за замовчуванням Kafka покладається на системний кеш ОС (Page Cache) і не робить системний викликfsyncна кожне повідомлення (дані скидаються фоново ядром ОС). Якщо від обох систем зажадати строго однакових гарантій негайного скидання на енергонезалежний носій до підтвердження продюсеру, різниця у швидкодії суттєво нівелюється. - Поведінка під час відмов вузлів: Дослідження Tanzu зафіксувало, що в моменти симуляції апаратних збоїв чи мережевих розривів у кластері з трьох нод стабілізація затримок у RabbitMQ Quorum Queues (завдяки формальному консенсусу Raft) відбувалася значно передбачуваніше, ніж у тодішній Kafka під координацією ZooKeeper.
Ця відкрита інженерна дискусія спонукала обидві платформи до якісного подолання власних історичних обмежень.
2. Поява Quorum Queues у RabbitMQ: Raft замість Mirrored Queues
Історично кластеризація RabbitMQ спиралася на технологію дзеркальних черг (Mirrored Queues / ha-mode). Вона мала суттєві вади: при розривах мережі (Network Partitions) виникав ризик розділення свідомості (Split-Brain), а синхронізація нової репліки повністю блокувала всю чергу.
Команда RabbitMQ повністю переглянула надійність і представила Quorum Queues:
- Черги реалізовані на базі суворого математичного алгоритму консенсусу Raft.
- Будь-який запис підтверджується більшістю вузлів кластера ($N/2 + 1$), гарантуючи захист від розсинхронізації та split-brain навіть при відмові окремих нод.
3. RabbitMQ Streams (2021+)
У релізі RabbitMQ 3.9 відбулася концептуальна конвергенція: розробники додали RabbitMQ Streams.
Команда RabbitMQ побачила, що частина користувачів мігрує на Kafka лише тому, що їм потрібен незмінний лог і реплей подій без розмноження черг у пам’яті. RabbitMQ Streams реалізував парадигму Kafka прямо всередині екосистеми Erlang:
- Створено Append-only лог на диску з неруйнівним читанням (Non-destructive consumption).
- Клієнти самі відстежують свій зсув (Offset).
- Розроблено новий швидкісний бінарний протокол, який дозволив на одному вузлі RabbitMQ перевищити показник у 1 000 000 повідомлень на секунду.
4. Перехід Kafka на KRaft (2022–2024)
Упродовж понад десятиліття керування метаданими в Apache Kafka спиралося на зовнішній ансамбль Apache ZooKeeper. ZooKeeper забезпечував розподілений консенсус, вибори контролера та відстеження конфігурацій топіків. Проте зі зростанням масштабів систем виявилися фундаментальні архітектурні недоліки, які заважали кластерам стабільно тримати навантаження:
- Подвійний стан та тривалий failover контролера: Стан кластера дублювався у пам’яті ZooKeeper та в оперативній пам’яті активного контролера Kafka. У разі аварії контролера новий вузол був змушений заново синхронно вичитувати весь масив метаданих усіх топіків та партицій із зовнішнього сховища. Це спричиняло тривалі затримки відновлення, під час яких кластер не міг обирати нових лідерів та опрацьовувати адміністративні зміни.
- Обмеження пропускної здатності метаданих: Будь-яка зміна топології генерувала лавину мережевих RPC між ZooKeeper, контролером і брокерами, створюючи надмірне навантаження на систему спостережень (Watches) та обмежуючи горизонтальне зростання кластера.
- Операційна складність: Необхідність супроводжувати дві окремі складні розподілені системи (ансамбль ZooKeeper та кластер Kafka) з різними мережевими портами, конфігураціями пам’яті та моделями безпеки.
У межах ініціативи KIP-500 інженери відмовилися від сторонньої координації та перейшли на нове власне рішення — протокол KRaft (Kafka Raft Metadata Mode):
- ZooKeeper повністю вилучено з архітектури (у версіях Kafka 3.x як рекомендований, а у 4.0 – як єдиний режим).
- Метадані кластера перетворено на внутрішній журнал подій самої Kafka, керований виділеним Raft-кворумом власних контролерів.
- Час відновлення контролера та обрання лідерів скоротився з хвилин до часток секунди, а керування метаданими перестало бути перешкодою для горизонтального масштабування.
Причина відмови полягала у невідповідності моделей навантаження. ZooKeeper створювався як ієрархічне деревоподібне сховище конфігурацій і блокувань у пам’яті (ZNode) для компактних даних із рідкісними змінами. Kafka ж намагалася зберігати в ньому динамічний стан розподілених потоків подій. Перехід на KRaft став уніфікацією архітектури: сама Kafka побудована навколо розподіленого журналу фіксації, тому для власних метаданих вона використала перевірений лог-орієнтований механізм замість стороннього дерева пам’яті.
Q&A
- Чому відмова від Mirrored Queues на користь Quorum Queues була критично необхідною для RabbitMQ? Mirrored Queues використовували специфічний пропрієтарний кільцевий протокол гарантованого мультикасту (GM – Guaranteed Multicast) без формального кворуму більшості: запис підтверджувався лише після згоди усіх дзеркал, а не більшості. При мережевих розривах це загрожувало розділенням свідомості (Split-Brain) або зависанням черги під час додавання нових реплік. Quorum Queues базуються на математично верифікованому алгоритмі Raft, де будь-яка мутація вимагає згоди більшості ($N/2 + 1$), гарантуючи сувору безпеку даних.
- Чи означає поява RabbitMQ Streams, що RabbitMQ тепер може повністю замінити Kafka? Ні. Хоча RabbitMQ Streams надає високопродуктивний Append-only лог (понад 1 млн msg/s), екосистема Kafka розрахована на великі дані: вбудований Kafka Connect (сотні конекторів до баз даних та озер даних), Kafka Streams / Flink для віконної аналітики подій у реальному часі (Event Stream Processing), централізований Schema Registry та спеціалізоване керування петабайтними сховищами. Streams у RabbitMQ вирішує локальні задачі логування та реплею подій безпосередньо у мікросервісному контурі.
Виробничі виклики (Production Messaging Challenges)
Досвідчений інженер оцінює технології не за простотою підключення стартера у фреймворку, а за тим, що відбувається з системою під час аварій та перевантажень.
1. Проблема подвійного запису (Dual-Write Problem) та Transactional Outbox
Типовий антипатерн бекенд-розробника:
// Антипатерн: ризик розсинхронізації даних
orderRepository.save(order);      // Крок 1: успішно зберегли в PostgreSQL
kafkaTemplate.send("orders", event); // Крок 2: мережевий таймаут до брокера!
Якщо після кроку 1 падає мережа або сервіс, замовлення збережене, але подія ніколи не потрапить у Kafka. Двофазний розподілений коміт (2PC/XA) у мікросервісах неприйнятний через критично високі затримки.
Рішення: Патерн Transactional Outbox. Подія зберігається в тій самій транзакції бази даних у таблицю outbox_events. Спеціалізований процес на базі CDC (Change Data Capture, наприклад, Debezium) вичитує бінарні логи транзакцій БД (Postgres WAL) і надійно транслює їх у Kafka.
2. Отруйні повідомлення (Poison Pills) та каскадні збої
Якщо продюсер публікує повідомлення зі зламаною схемою JSON/Avro, консьюмер кидає виняток десеріалізації.
У RabbitMQ за замовчуванням неправильна конфігурація слухача може спричинити відхилення basic.nack(requeue=true). Брокер миттєво повертає зламане повідомлення назад у голову черги, утворюючи нескінченний цикл, що випалює процесор на 100%.
Рішення: Налаштування суворої політики перенаправлення у чергу помилок (Dead Letter Queue / DLQ). У Kafka застосовується патерн Non-blocking Retry Topics (наприклад, анотація @RetryableTopic у Spring Kafka зі зростаючим експоненційним backoff: orders-retry-1s, orders-retry-5s, orders-dlq), що запобігає блокуванню основної партиції.
3. Відставання споживачів (Consumer Lag) та явище Backpressure
- У RabbitMQ: Накопичення черги призводить до вичерпання RAM. Брокер активує захисний режим Flow Control: він примусово призупиняє читання з сокетів продюсерів, створюючи зворотний тиск (Backpressure) по всьому стеку.
- У Kafka: Черги не займають оперативну пам’ять, оскільки пишуться на диск. Проте відставання понад обсяг виділеного Page Cache призводить до промахів повз пам’ять (Cache Misses) і падіння латентності читання.
4. Шторми перебалансування у Kafka (Consumer Group Rebalances)
Раніше додавання нового Pod-а в Kubernetes викликало глобальну паузу «stop-the-world» для всієї групи споживачів (Eager Rebalance Protocol). Якщо споживач довго обробляв важку пачку даних і перевищив інтервал max.poll.interval.ms, брокер вважав його мертвим, викидав із групи та запускав лавиноподібне перебалансування на інших вузлах.
Рішення:
- Використання протоколу Cooperative Sticky Assignor: перерозподіляються лише ті партиції, які дійсно змінюють власника, без зупинки роботи всієї групи.
- Застосування Static Group Membership у Kubernetes (
group.instance.id), що запобігає перебалансуванню при швидкому перезапуску контейнера.
5. Порядок подій проти паралелізму та ретраїв (Ordering vs Retries)
У розподілених системах наївна реалізація повторних спроб (Retries) часто непомітно руйнує хронологічну послідовність взаємопов’язаних бізнес-подій.
Сценарій проблеми: Клієнт генерує дві пов’язані події: Event #1: Створення рахунку та Event #2: Списання коштів. Якщо обробка Event #1 зазнає тимчасового збою і повідомлення відправляється у non-blocking retry-топік із затримкою 5 секунд, консьюмер тим часом бере в роботу Event #2. Спроба списати кошти з іще не створеного рахунку призводить до логічної аварії та розсинхронізації стану.
Рішення:
- Партиціонування за сутностями: Події з однаковим бізнес-ключем (
aggregate_id, наприкладaccount_id) завжди спрямовуються в одну партицію Kafka. - Блокуючий ретрай проти неблокуючого: Якщо суворий порядок для ключа є критичним, неблокуючі retry-топіки неприпустимі. Застосовується In-Partition Retry із фіксованим лімітом спроб (наприклад, 3 спроби з паузою backoff 200 мс прямо в поточному потоці). Якщо помилка не усувається, уся партиція для цього ключа призупиняється (або сутність маркується як заблокована у сховищі), запобігаючи виконанню наступних подій до локалізації інциденту.
6. Еволюція схем даних та контракти (Schema Drift & Compatibility)
У розподілених середовищах продюсери та консьюмери розробляються і деплояться незалежними командами. Зміна типу поля, перейменування чи видалення обов’язкового атрибута в тілі повідомлення неминуче призводить до аварії консьюмерів із фатальною помилкою десеріалізації (Poison Pill).
Рішення:
- Відмова від нетипізованого JSON на користь бінарних протоколів із суворою схемою: Apache Avro або Protocol Buffers (Protobuf).
- Використання централізованого Schema Registry: брокер або клієнтська бібліотека валідує схему перед публікацією. Повідомлення містить лише компактний числовий ідентифікатор схеми (
schema_id), а не повний метаопис полів. - Дотримання правил сумісності:
- BACKWARD: Новий консьюмер коректно читає повідомлення, записані продюсерами старого формату.
- FORWARD: Старий консьюмер здатний опрацьовувати повідомлення нового формату (ігноруючи невідомі нові атрибути).
- FULL: Одночасна зворотна та пряма сумісність, що гарантує безшовне розгортання сервісів у довільній послідовності.
7. Ідемпотентність споживача та патерн Inbox (Idempotent Consumer & Inbox Pattern)
В асинхронних мережах семантика доставки At-Least-Once неминуче породжує дублікати: продюсер може не отримати підтвердження (ACK) через мережевий таймаут і повторити публікацію; консьюмер може впасти після виконання бізнес-дії, але до фіксації зміщення (Offset Commit).
Рішення:
- Принцип ідемпотентності: Повторна доставка того самого повідомлення не повинна змінювати стан системи понад перший виклик: \(f(f(x)) = f(x)\)
- Патерн Inbox: Кожне повідомлення маркується глобально унікальним UUID (
message_idабоevent_id). - Практичні способи дедуплікації:
- Реляційна база даних: Збереження
message_idу таблицюinbox_messagesв одній локальній ACID-транзакції зі зміною бізнес-сутності. Завдяки унікальному обмеженню (PRIMARY KEY (message_id)), повторне повідомлення автоматично ігнорується механізмомINSERT ... ON CONFLICT DO NOTHING. - Швидкий розподілений кеш (Redis): Атомарна перевірка та встановлення ключа через команду
SET key value NX EX ttl(деEXвизначає час життя, наприклад, 24 години). Якщо ключ уже існує в базі, повідомлення негайно підтверджується без повторного запуску бізнес-логіки.
- Реляційна база даних: Збереження
Q&A
- Як зберегти строгий порядок подій одного клієнта, якщо обробка повідомлення завершилася помилкою? Необхідно застосовувати блокуючий ретрай у межах тієї самої партиції (In-Partition Retry). Не можна спрямовувати одне проблемне повідомлення в неблокуючу retry-чергу, якщо наступні події за тим самим ключем продовжують опрацьовуватися в основному топіку, адже це порушить хронологію транзакцій.
- Чому для високонавантажених топіків обирають Avro або Protobuf замість JSON? Avro та Protobuf забезпечують компактний бінарний розмір (у 3–5 разів менший за JSON), швидку серіалізацію без текстового парсингу та захист від каскадних помилок завдяки суворій валідації сумісності через Schema Registry.
- Чи достатньо увімкнути ідемпотентного продюсера у Kafka (
enable.idempotence=true), щоб гарантувати бізнесу обробку строго один раз? Ні. Ідемпотентний продюсер усуває дублікати виключно на шляху «продюсер $\to$ брокер» за допомогою внутрішніх послідовних номерів (Sequence Numbers). Він не захищає від дублювання обробки на боці споживача при аваріях консьюмера до коміту офсету. Повноцінний Exactly-Once досягається лише надійним транспортом разом із патерном Inbox або дедуплікацією на рівні бази даних споживача.
Патерни спільного використання в корпоративних платформах
Сучасний дизайн розподілених систем відмовляється від бінарного вибору «Kafka або RabbitMQ». Найбільш зрілі платформи застосовують обидва інструменти одночасно, розділяючи відповідальність за принципом: Kafka як ядро потокових даних (Event Backbone), RabbitMQ як диспетчер завдань та адресних сповіщень (Task & Notification Dispatcher).
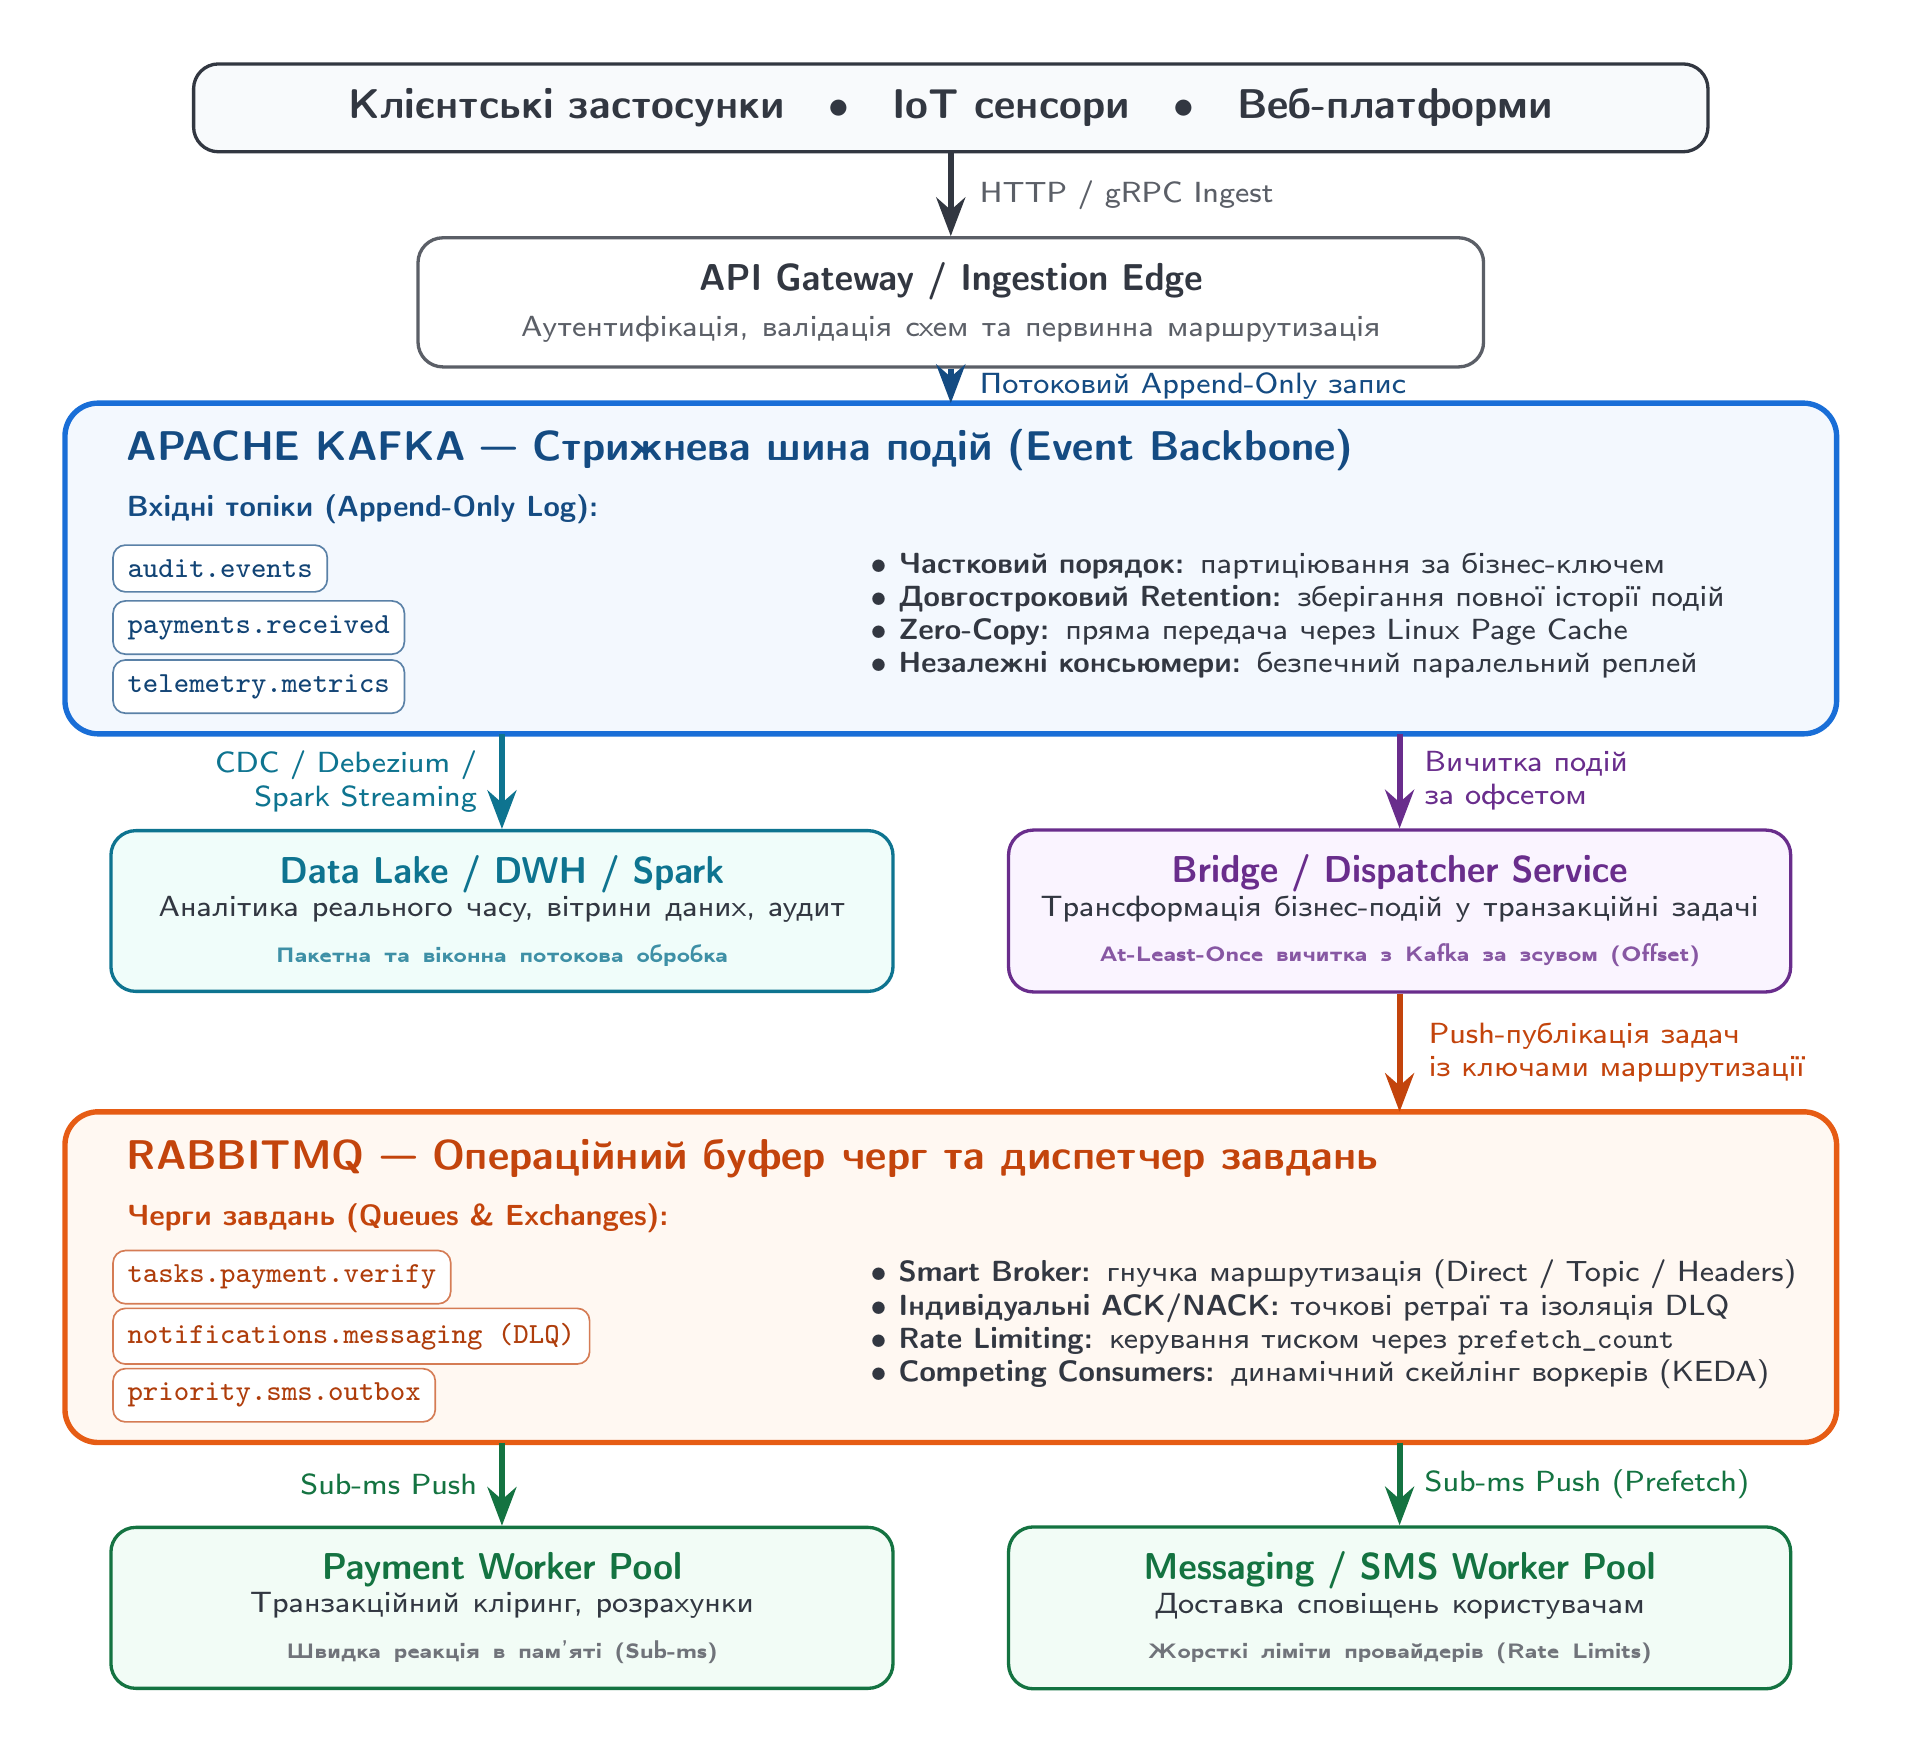 Рис. 6. Архітектурний симбіоз Apache Kafka та RabbitMQ у корпоративній платформі: розподіл обов’язків між стрижневим журналом подій (Event Backbone) та оперативним диспетчером черг і сповіщень (Task Dispatcher).
Розподіл зон відповідальності в платформі:
- Вхідний контур та аудит (Apache Kafka):
- Центральний нерв системи: Усі бізнес-події первинно публікуються в Kafka (
orders.placed,payments.transacted). Kafka приймає колосальний потік даних продюсерів, гарантуючи збереження незмінного журналу фіксації. - Аналітика та ретроспектива: Паралельно з бізнес-обробкою команди DWH, аналітики реального часу (Flink/Spark) та аудиту підключаються до топіків як незалежні консьюмери без створення навантаження на продюсерів чи оперативну пам’ять брокера.
- Центральний нерв системи: Усі бізнес-події первинно публікуються в Kafka (
- Міст інтеграції (Bridge / Dispatcher Service):
- Легковаговий сервіс-підписник вичитує події з Kafka. Якщо подія вимагає виконання термінового транзакційного завдання (наприклад, надсилання персонального сповіщення або виклик зовнішнього банківського шлюзу), сервіс трансформує подію в команду і публікує її в RabbitMQ з відповідним ключем маршрутизації (
Routing Key).
- Легковаговий сервіс-підписник вичитує події з Kafka. Якщо подія вимагає виконання термінового транзакційного завдання (наприклад, надсилання персонального сповіщення або виклик зовнішнього банківського шлюзу), сервіс трансформує подію в команду і публікує її в RabbitMQ з відповідним ключем маршрутизації (
- Операційний контур виконання (RabbitMQ):
- Адресна маршрутизація: RabbitMQ використовує гнучкість обмінників (Topic/Headers Exchanges) для доставки завдань спеціалізованим пулам воркерів.
- Еластичне автоскейління через Competing Consumers: На відміну від Kafka, де кількість паралельних споживачів у групі жорстко обмежена кількістю партицій топіка, черги RabbitMQ дозволяють нативно масштабувати пул воркерів за патерном Competing Consumers (наприклад, через Kubernetes KEDA за глибиною черги). Під час сплесків навантаження можна динамічно підняти хоч 50 або 100 подів на одну чергу без необхідності модифікувати брокер чи проводити складне перерозподілення партицій.
- Ізоляція невдалих спроб (DLQ) та лімітування швидкості: Зовнішні провайдери (платіжні шлюзи, месенджери) мають жорсткі ліміти пропускної здатності (Rate Limiting). RabbitMQ дозволяє консьюмерам вичитувати завдання строго відповідно до квот (
basic.qos(prefetch_count)), а зламані запити миттєво ізолювати в Dead Letter Queues без зупинки чи блокування решти черги. - Миттєве звільнення ресурсів: Щойно воркер відправив повідомлення або провів транзакцію, брокер отримує підтвердження (
ACK) і миттєво знищує конверт з оперативної пам’яті, підтримуючи мінімальну затримку (Round-Trip Latency).
Такий синергетичний патерн усуває слабкості обох платформ: Kafka звільняється від необхідності реалізації складних per-message ретраїв та індивідуальної маршрутизації, а RabbitMQ захищений від переповнення пам’яті терабайтами історичних даних.
Висновки
Аналіз двадцятирічної історії та математичних моделей розподілених систем доводить: між Apache Kafka та RabbitMQ немає і не може бути протистояння за принципом «один інструмент кращий за інший».
- RabbitMQ – неперевершений інструмент для гнучкого роутингу, складних черг повідомлень, швидкої доставки транзакційних задач у пам’яті та ізольованої обробки помилок за моделлю «розумного брокера».
- Apache Kafka – магістральний розподілений журнал фіксації для високопродуктивних потоків подій, довгострокового зберігання історії, аналітики реального часу та відв’язки десятків незалежних систем через парадигму «незмінного логу».
Зрілий архітектурний підхід полягає не у виборі єдиного брокера на всі випадки, а у розумінні фізичних компромісів та математичних меж, що дозволяє органічно поєднувати сильні сторони кожної системи у єдиній відмовостійкій архітектурі.